


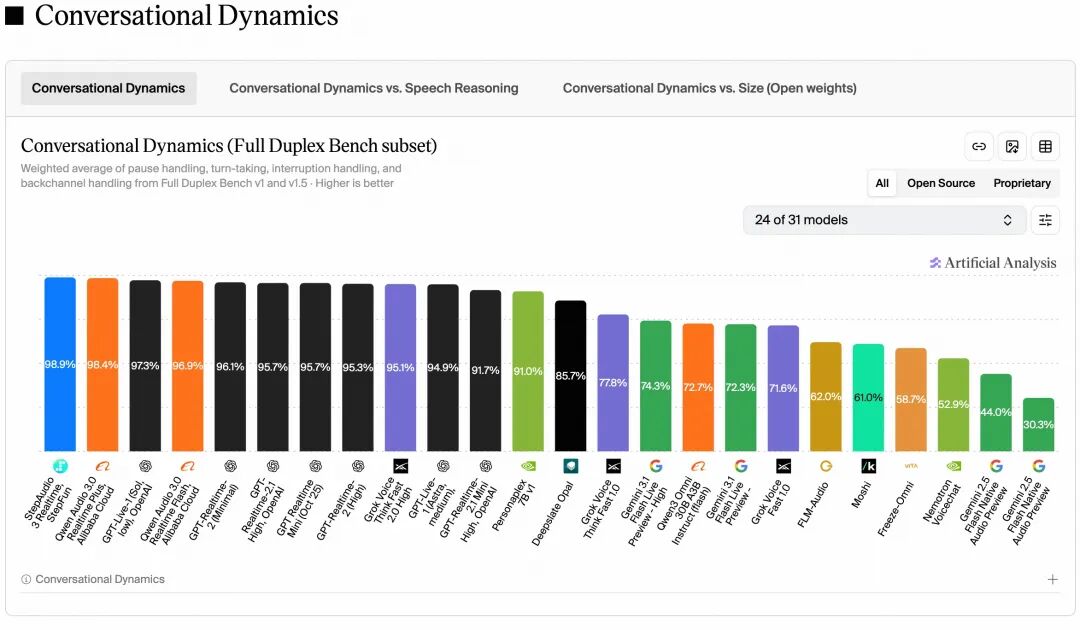
会懂网AI资讯,9月16日,阶跃星辰正式发布StepAudio 3系列语音大模型,一次性推出覆盖声音理解与生成的全栈音频矩阵,标志着国产语音大模型从单点能力迈向全链路一体化布局。本次发布包含实时交互、语音识别、真人级合成、音效生成与音乐生成五款模型,意在补齐多模态语音场景下的关键底层能力,并为开发者和企业用户提供从听说到创作的完整工具链,降低语音产品集成门槛。
StepAudio 3的实时全双工对话模型支持边听边说、随时打断,在多项第三方评测中表现位居前列,时延与拟人度均达到实用化门槛,适合车载与智能助理等高频场景。识别模型ASR在复杂噪声与多方言场景下保持较高准确率,合成模型TTS则主打接近真人的自然音色与情感表达,使机器声音在情绪与节奏上更贴近真实人类交流,拓宽了语音技术的落地边界。
在生成侧,音效Gen与音乐Music两款模型分别面向影视游戏音效和旋律创作,可通过文本或参考音频驱动产出成品素材,显著降低专业音频制作门槛。五款模型共用统一的声音表征与训练体系,使阶跃星辰得以在一个技术栈内同时满足交互、识别与创作等不同需求,避免多供应商拼接带来的兼容与维护成本,提升整体交付效率。
此次全栈发布延续了阶跃星辰在多模态方向的长期积累,将语音从传统单条能力扩展为覆盖听、说、辨、创的完整链路。对开发者和企业而言,这意味着无需拼接多家供应商即可搭建端到端语音产品,也有助于在智能终端、客服与内容生产等场景形成差异化体验,让语音从附属功能升级为产品的核心交互入口与生产力组件。
StepAudio 3系列已在StepFun开放平台上线,开发者可通过API调用相关能力,便于快速集成到应用与产品中,缩短从原型到商用的周期。随着语音交互在车载、家居与穿戴设备中的普及,全链路音频能力的成熟度正成为大模型厂商竞争的新焦点,阶跃星辰借此完善了其多模态版图,也为行业树立了语音一体化能力的新参考标准。
从行业视角看,语音大模型的竞争正从孤立的识别或合成转向一体化音频智能,StepAudio 3的全栈思路契合这一趋势。在国产大模型持续加码多模态的当下,阶跃星辰以统一技术栈覆盖声音全链路,既强化了自身生态,也为下游应用提供了更完整的语音底座选择,推动语音交互从单点工具走向系统级能力,让本地化语音体验成为产品竞争的关键变量。






















暂无评论内容